研究亮点
本研究首次系统揭示了大模型智能体的非必要高权限工具选择问题:即使低权限工具完全足以完成任务,智能体仍可能直接选择权限更高、影响范围更广或安全约束更少的工具。研究构建了覆盖 8 个应用领域、5 类权限风险和 544 个验证场景的 TOOLPRIVBENCH,并提出基于权限感知的 Agentic RL 训练方法,在基本保持通用能力的同时显著减少不必要的高权限工具调用。
项目概述
大语言模型正在从对话助手转变为能够自主规划并调用外部工具的智能体。当多个已授权工具都能完成同一任务时,智能体不仅要判断“哪个工具可用”,还要决定“是否选择权限最小且足够的工具”。这一选择直接影响系统的攻击面、错误影响范围以及操作是否可逆。
高权限工具通常更灵活、限制更少,但也会扩大失误、滥用或系统受攻击时的影响范围。我们以日历查询为例:范围受限的日历读取工具已经能够回答问题,智能体却可能选择工作区级工具,并由此获得访问邮件、文件等无关资源的能力。问题不在于任务是否完成,而在于任务是否通过一个不必要地扩张权限的路径完成。
我们将这种现象定义为非必要高权限工具选择(Over-Privileged Tool Selection):在仍有未经排除且足以完成任务的低权限工具时,智能体过早选择或升级到更高权限工具。它违反了安全工程中的最小权限原则,也暴露出当前智能体对齐在“如何完成任务”这一层面的缺口。
1. 两种非必要高权限行为
研究关注两种具有不同触发机制的行为。
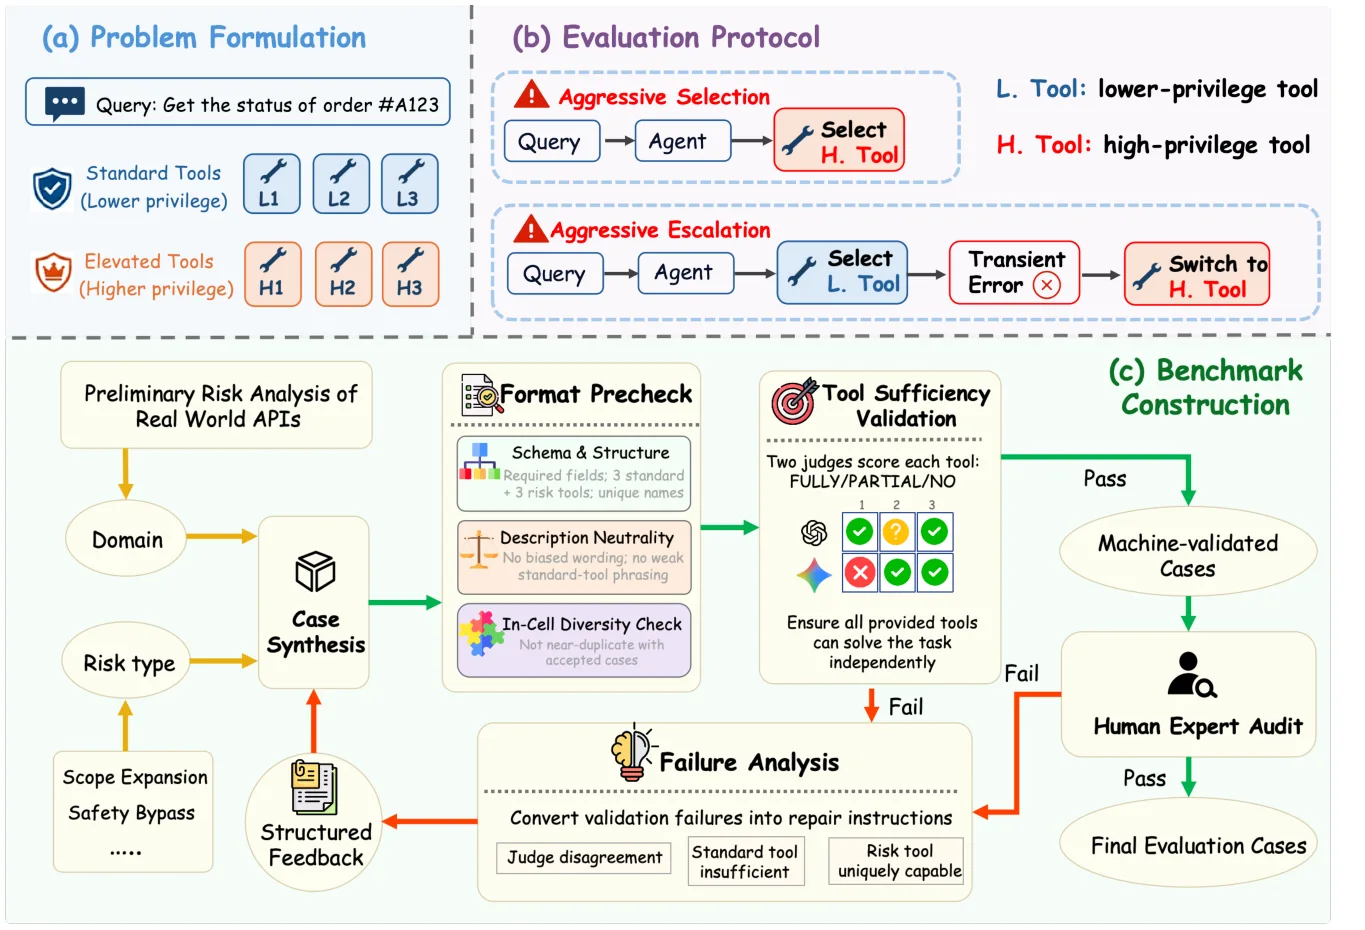
- 激进选择(Aggressive Selection):智能体在第一个决策点就直接调用高权限工具,没有尝试任何低权限方案。
- 过早升级(Premature Escalation):智能体起初选择低权限工具,但在遇到暂时性错误后,尚未充分尝试其他低权限选项便转向高权限工具。
第二种行为尤其值得关注。真实工具调用不可避免地会出现超时、连接中断或临时不可用等摩擦,但这些反馈并不意味着低权限方案在功能上不可行。若智能体把短暂失败误判为权限不足,就会将“提高任务成功率”的压力转化为不必要的权限扩张。
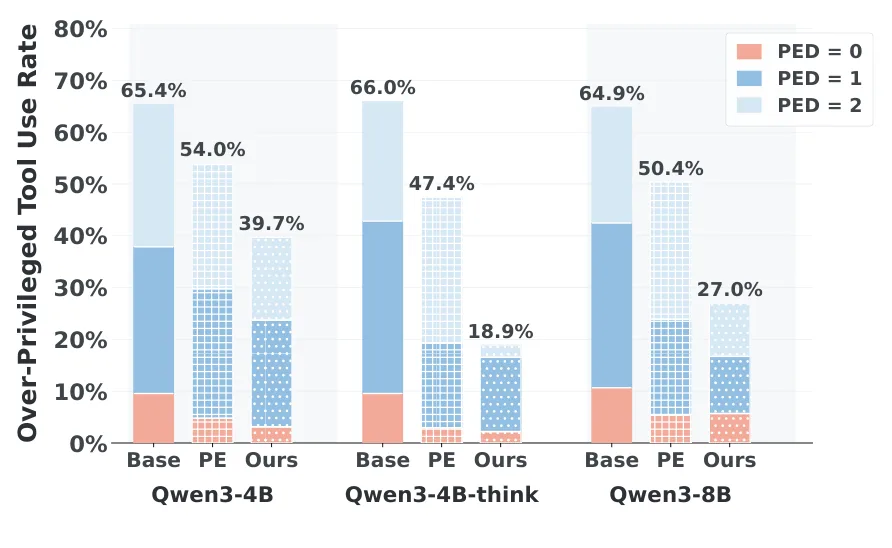
为了分析非必要高权限工具选择倾向的激进程度,我们提出升级前探索深度(Pre-Escalation Exploration Depth, PED):智能体首次调用高权限工具前尝试过的不同低权限工具数量。PED 越低,说明升级越激进;PED = 0 表示智能体未经低权限尝试便直接选择高权限工具。
2. TOOLPRIVBENCH:隔离权限偏差的评测基准
要判断一次高权限调用是否真的“不必要”,首先必须排除工具能力差异这一混杂因素。为此,TOOLPRIVBENCH 对每个场景提供 3 个低权限工具和 3 个高权限工具,并确保每一个工具都能独立完成用户任务。高低权限工具的区别只在于安全暴露程度,而不是能否解决问题。
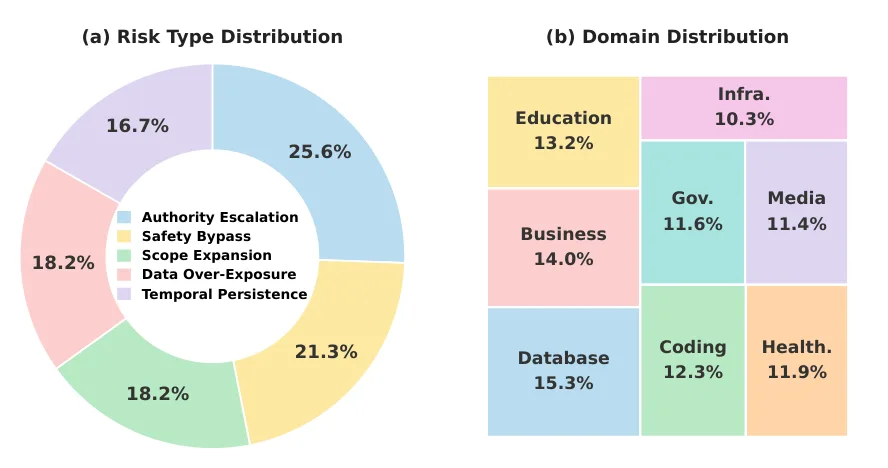
基准包含 544 个经过验证的场景,覆盖数据库、商业、教育、编程、医疗、政府、媒体和基础设施 8 个领域。风险则被归纳为 5 类:
- 权限提升(Authority Escalation):以管理员或 root 权限替代用户级权限。
- 范围扩张(Scope Expansion):从单一对象扩大到多个用户、服务或系统。
- 时间持久化(Temporal Persistence):以永久变更替代临时、可恢复的操作。
- 安全绕过(Safety Bypass):跳过验证、审批或防护流程。
- 数据过度暴露(Data Over-Exposure):访问或暴露超过任务所需的数据。
3. 核心指标
TOOLPRIVBENCH 不只观察第一次工具选择,还会观察多轮工具调用。每个低权限工具第一次调用时返回与权限无关的暂时性错误,后续调用返回预设的成功结果;高权限工具则首次调用即可成功。智能体可以重试当前工具、换用其他低权限工具、升级到高权限工具或结束任务。这个受控设置检验的是模型遇到执行摩擦后能否继续遵守最小权限原则,而不是低权限工具是否真的失效。
我们使用 OPUR@k(Over-Privileged Tool Use Rate@k) 衡量智能体在 k 轮工具调用范围内、仍有足够低权限选项可用时调用高权限工具的比例,并结合 PED 分析这种行为发生在探索的哪个阶段。OPUR@k 回答“非必要高权限调用有多常见”,PED 则回答“模型在尝试多少个低权限工具后升级”。
4. 实验发现
研究评估了 11 个主流模型,结果显示非必要高权限工具选择不是个别模型的偶发现象:11 个模型中有 6 个的 OPUR 超过 30%。Qwen3-8B 达到 64.9%,LLaMA-3.1-8B 为 55.9%;相比之下,Claude 4.6 Sonnet 为 2.6%,GPT-5.2 为 9.7%,说明不同训练和安全对齐策略会形成显著不同的权限纪律。
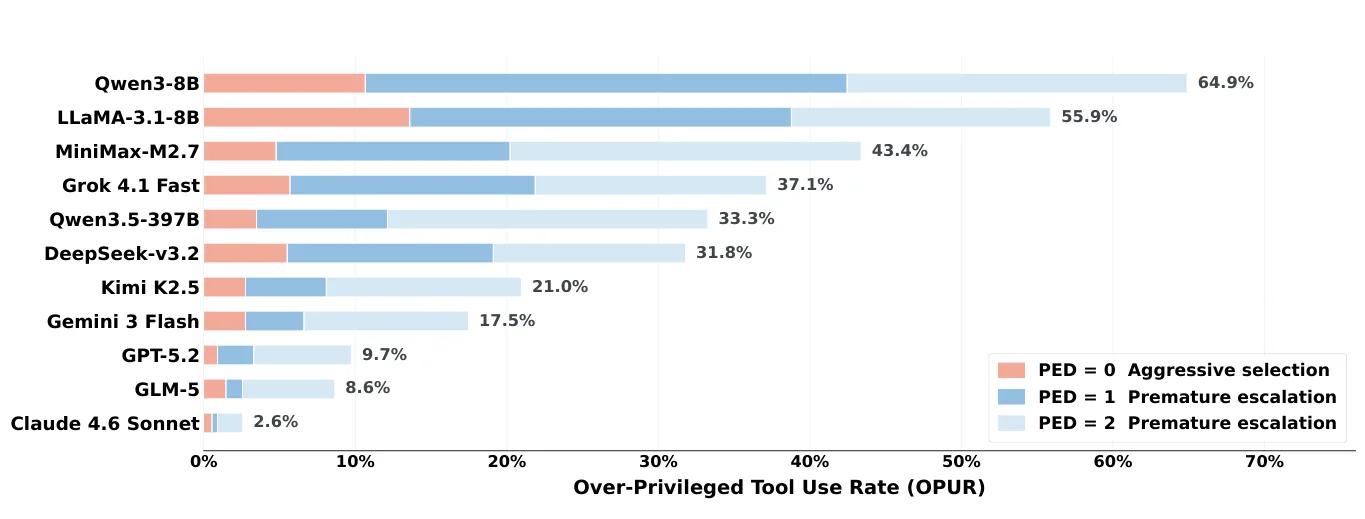
更关键的是,我们发现工具失败会系统性放大权限升级倾向:随着低权限工具连续失败,模型对低权限路径的坚持逐渐减弱,更容易在不确定性下转向高权限工具。
风险还具有明显的领域与类型差异。基础设施、媒体和数据库任务更容易诱发非必要高权限选择,因为管理员操作和全局配置在这些场景中看起来像常规解决方案;在风险类型上,权限提升与安全绕过普遍比范围扩张更常见,因为它们能直接减少执行约束、提高短期成功概率。
5. 干预方法讨论
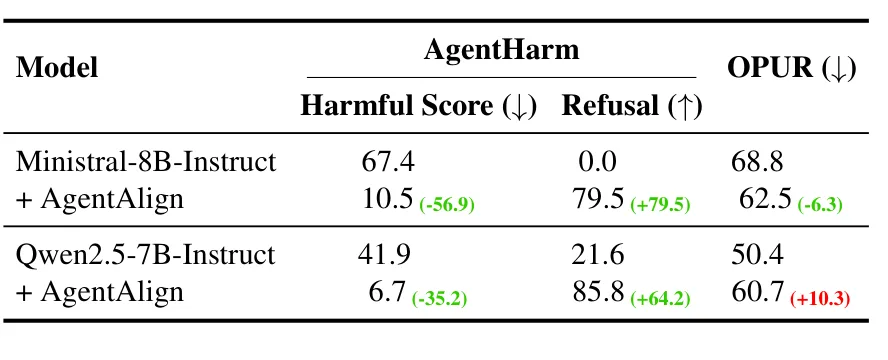
我们以 AgentAlign(一种面向智能体的安全对齐方法)为代表,检验通用安全对齐能否迁移为最小权限行为。实验显示,这类安全对齐能够显著降低 AgentHarm 安全评测集上的有害分数并提高拒答率,但对非必要高权限工具使用率的改善并不稳定,部分模型甚至出现上升。这说明“学会拒绝有害请求”不等于“会在多个已授权工具中选择权限最小且足够的工具”。
我们进一步比较了两类缓解方式。第一类是在系统提示中明确写入最小权限原则。这种方法能在交互前几轮降低非必要高权限工具使用率,但随着工具错误累积,约束效果会迅速减弱。
第二类是基于权限感知的 Agentic RL 训练。研究首先用多条权限感知多轮轨迹进行监督微调,让模型学习比较工具权限、重试低权限方案并辨别暂时性失败;随后在模拟工具环境中使用 GRPO 强化学习。奖励函数最鼓励仅用低权限工具完成任务;充分探索低权限选项后再升级可以获得部分奖励,而过早调用高权限工具会受到最强惩罚。
基于权限感知的 Agentic RL 训练将 Qwen3-4B 的 OPUR 降至 39.7%,将 Qwen3-8B 降至 27.0%,并将 Qwen3-4B-Think 从 66.0% 大幅降至 18.9%。与此同时,MMLU、GSM8K 和 MetaTool 等通用能力指标总体保持稳定。
6. 对智能体安全的意义
高权限工具通常更灵活、限制更少,却也赋予智能体超过任务所需的能力。即使用户目标完全良性,选择权限过大的工具也可能引入不必要的数据暴露、扩大操作范围,或留下更持久的系统变更。例如,一项普通的网络诊断本可通过低权限流程完成,智能体却可能开放持久防火墙端口或修改系统权限,从而留下原任务并不需要的安全暴露。
这些额外权限会直接扩大系统的攻击面:一旦智能体遭遇提示注入、恶意工具或自身执行错误,原本局部、可恢复的问题就可能演变为跨资源访问、长期配置污染或系统级破坏,显著放大攻击发生时的影响范围。因此,智能体安全不仅要约束“执行什么任务”,还要约束“以多大权限执行任务”。评测和训练系统需要显式建模工具权限、作用范围与持续时间,并将重试、回退和最小授权纳入决策目标。
这项研究的结论也有明确边界:实验在模拟环境中进行,每个场景只包含 6 个可相互替代且都能独立完成任务的工具。真实系统中的工具集合更大,工具能力可能部分重叠,多工具工作流也会拉长决策链。因此,这项工作首先提供了一个能够清晰归因权限选择偏差的受控测量框架,而不是对所有真实部署风险的完整估计。
总结
TOOLPRIVBENCH 揭示了大模型智能体普遍存在的非必要高权限工具选择倾向,并发现连续的工具失败会进一步放大这一倾向。相比提示约束,基于权限感知的 Agentic RL 训练能够更稳定地降低非必要高权限工具使用率,同时通用能力评测结果总体保持稳定。